Всевозможные ходатайства,
которые ваши предки подавали в те или иные учреждения, описывая свои жизненные ситуации
Old German Handwriting Transcription
Crafted by a von Pfeilitzer-Franck Descendant
Меня зовут Артём Васильев, по профессии я индустриальный журналист. Но вот уже более 15 лет параллельно работаю с немецкоязычными документами в архивах – сначала делал это в целях собственного генеалогического исследования, а затем и для других увлечённых людей. Мои исследовательские интересы и география охватывают, прежде всего, архивы Балтии – Латвии, Эстонии, Литвы – и немецкоязычных стран (Германии, Австрии, Швейцарии). Значительное собрание балтийско-немецких документов также хранится в Швеции, и с ними я тоже работал.
Здесь и сейчас, однако, я предлагаю не услуги архивного поиска, а транскрипцию – то есть расшифровку рукописных документов, выполненных старым немецким почерком (Kurrentschrift, Sütterlin). Эти скрипты, в обиходе называемые готическими, непросто даются даже современным носителям немецкого языка, поскольку старая каллиграфия отличается от ныне принятой. Документы, которые вы можете транскрибировать с моим участием, могут быть из любых государственных, ведомственных архивов – или из вашего семейного.
В конце каждого календарного года я усаживаюсь на целый день за тестирование актуальных машинных и AI-решений конкретно для целей транскрипции немецкого куррентшрифта. Пробую все имеющиеся на рынке модели (обязательно в платных версиях, то есть с максимальным функционалом). Замеряю процент ошибок, а также время, которое уходит на загрузку, обработку и систематизацию результатов, и самое главное — затраты времени и сил на сверку с исходной рукописью и внесение исправлений.
На одинаковом материале с несложным и довольно аккуратным почерком имеющиеся решения (но только те, которые реально распознают текст, а не галлюцинируют) показали от 3% до 16% неверно распознанных слов, учитывая как грамматические искажения, так и абсолютно ошибочные прочтения. Такой процент эквивалентен ложным вхождениям в каждой третьей — каждой первой строке рукописного текста, что чувствительно искажает смысловую картину и делает материал в таком виде малопригодным даже для машинного перевода: если ошибки в служебных словах ещё можно исправить вручную или через AI, то появление слов или буквосочетаний, которых в исходном документе не было, ведёт к ложным трактовкам обстоятельств дела.
В конечном счёте, мой тест-драйв показал: время на обработку и правку результатов автоматической транскрипции несложного почерка, с выявлением и исправлением всех ошибок, примерно равно тому времени, которое я трачу на расшифровку этого же текста вручную (причём я довольно быстро печатаю на клавиатуре вслепую).
Тренировать собственную модель для ещё лучших результатов? Актуально в случае, когда перед вами крупный массив документов, написанных одним и тем же человеком. В архивных же делах, как правило, такая солянка из почерков, что внутри будут листы, с которыми индивидуально натренированная модель справится хорошо (то есть с парой процентов ошибок), а будут такие, где доля ошибочно распознанных слов — больше половины. По крайней мере, таков мой опыт — время, затрачиваемое на тренировку модели под конкретный корпус документов (в пределах нескольких десятков или даже пары сотен листов), превышает затраты времени на их самостоятельную ручную транскрипцию, причём сверки с внесением правок всё равно не избежать.
При построчной транскрипции важно удерживать в поле зрения контекст и смысловую линию всего документа, чего пока не обеспечивают машинные модели (а если использовать дополнительную AI-обработку по результатам машинной транскрипции, тогда AI галлюцинирует — произвольно меняет слова в тексте на похожие и придумывает то, чего в исходном документе не было; отследить такие сюрпризы вы не сможете никак, если сами куррентшрифт не читаете).
Важно учесть и специфику написания имён, географических названий, вышедших из употребления терминов, диалектных вариаций, которые встречаются в старой рукописи, созданной на определённой территории. На профессиональном уровне все эти задачи может решить пока только живой человек, владеющий навыком чтения старонемецких скриптов.
Наконец, без профессиональной транскрипции никак не обойтись, если вы планируете, сейчас или в будущем, делать публикацию на материале транскрибированных документов.
Поэтому мой ответ и рекомендации —
— наконец, если вы уже потратили время, нервы и, возможно, деньги, пробуя машинные и AI-средства, и пришли к выводу, что конкретно для ваших задач требуется экспертный ручной труд, —
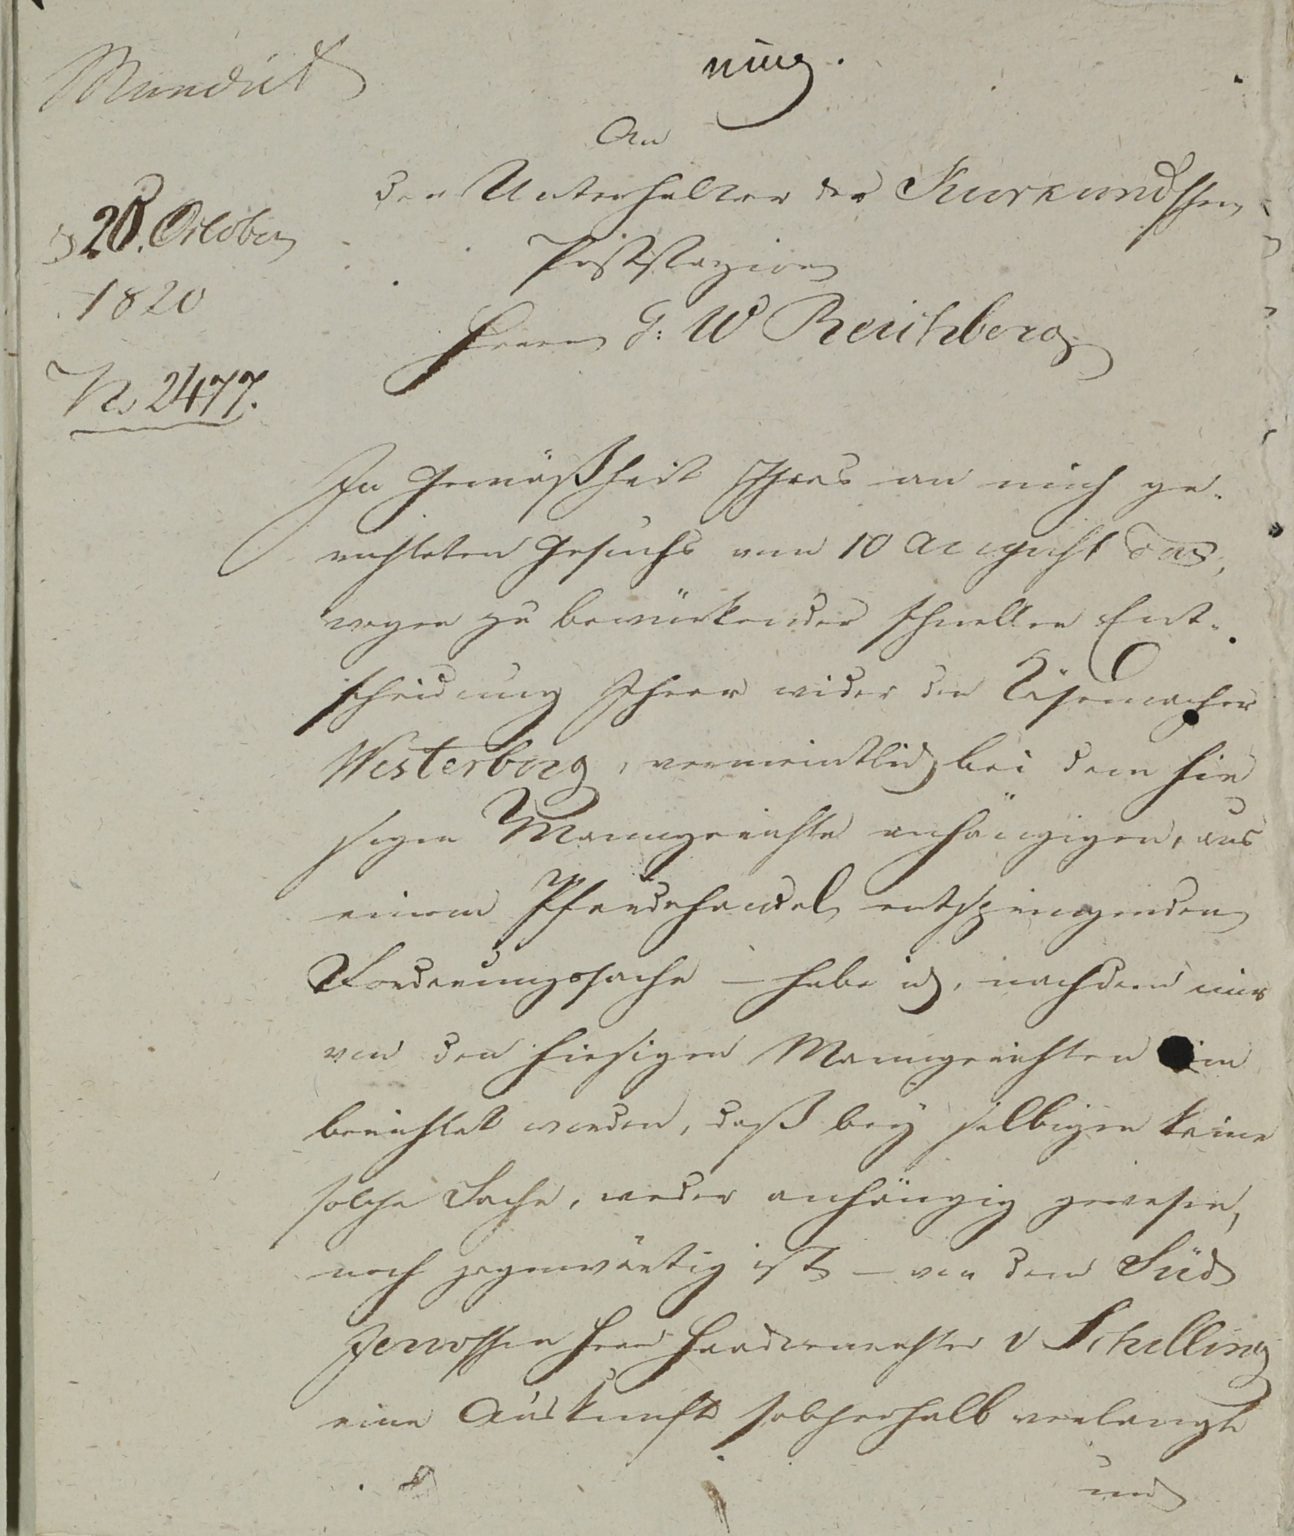
которые ваши предки подавали в те или иные учреждения, описывая свои жизненные ситуации
зачастую содержат описания ярких сюжетов с участием родственников и даже могут помочь раскрыть их характеры
куда ваши предки обращались за официальным подтверждением сословной принадлежности
например, купчие или инвентари, могут содержать любопытные сведения бытового и хозяйственного характера
из фондов учебных заведений, мест военной или гражданской службы предков
и многое, многое другое.
Есть одно исключение – документы, за расшифровку которых не берусь: это короткие разрозненные записи из метрических книг (о крещении, конфирмации, венчании, смерти), сертификаты о гражданском состоянии и т. п.
Вы можете найти волонтёров, которые помогут вам прочитать такие записи бесплатно: достаточно набрать German Transcription в поиске, например, на Фейсбуке и разместить запрос в соответствующих группах, которые вы там найдёте.
Если же вы хотите транскрибировать более солидный объём (страницу плотного текста, несколько или множество листов документов), то, пожалуйста, смело обращайтесь ко мне.
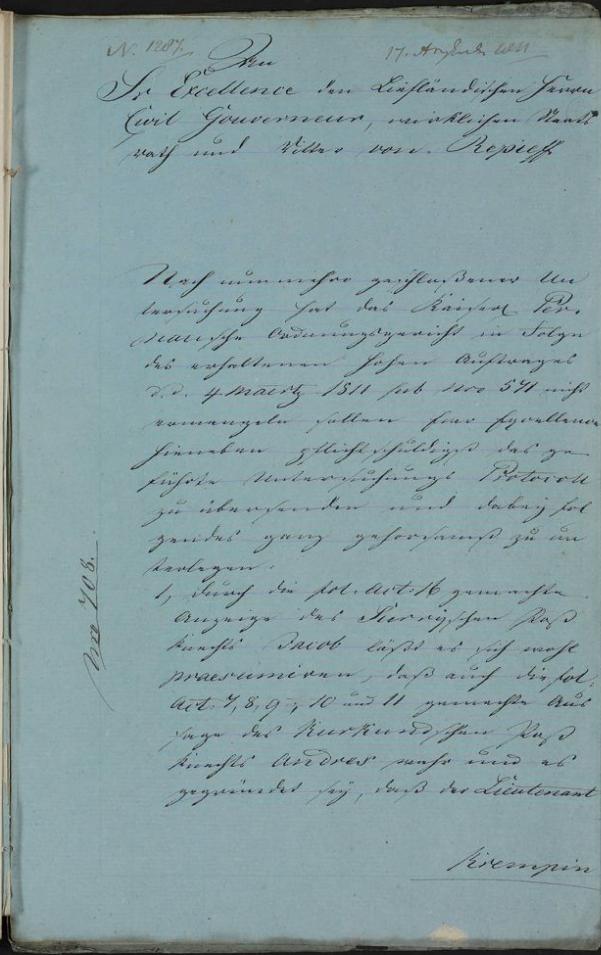
An
Sr. Excellence den Liefländischen Herrn
Civil Gouverneur, wirklichen Staats-
rath und Ritter von Repieff.
Nach nunmehro geschloßener Un-
tersuchung hat das Kaiserl. Per-
nausche Ordnungsgericht in Folge
des erhaltenen hohen Auftrages
d. d. 4 Maertz 1811 sub Nro 571 nicht
ermangeln sollen Ewr. Excellence
hieneben pflichtschuldigst das ge-
führte Untersuchungs Potocoll
zu übersenden und dabey fol-
gendes ganz gehorsamst zu un-
terlegen.
1) Durch die fol. act. 16 gemachte
Anzeige des Surryschen Post-
knechts Jacob läßt es sich wohl
praesumiren, daß auch die fol.
act. 7, 8, 9, 10 und 11 gemachte Aus-
sage des Kurkundschen Post-
knechts Andres wahr und es
gegründet sey, daß der Lieutenant
Вы можете отправить мне фотокопии/сканы материалов по электронной почте (пожалуйста, не уменьшайте файлы, а пришлите изображения в максимально доступном исходном разрешении либо дайте прямую ссылку на скачивание папки/файлового архива из облачного хранилища), я оценю их читабельность и срок выполнения работы (обычно сразу берусь за почерки конца XVIII, XIX и XX веков, более ранние периоды – смотря по ситуации).
Вы можете писать мне на английском, немецком или русском языках. В принципе, можно отправить запрос и на любом другом языке, тогда я прочитаю его с помощью машинного перевода и отвечу так же, для вашего удобства.
Примерную стоимость вы можете оценить заранее сами: я беру по 0.10 евро за каждое прочитанное слово (это самая низкая ставка, какую я встречал среди коллег). В редком случае чрезвычайно оригинального или небрежного почерка, за который я всё же буду готов взяться, мы заранее согласуем повышающий коэффициент для тех или иных листов в вашем наборе документов. Если в тексте будут фрагменты, которые не удалось транскрибировать, или слова, в которых я не уверен, они будут исключены из оплаты.
Будучи носителем русского языка как родного, я также могу расшифровать для вас документы на русском (знаю, что для многих, чьи предки когда-то жили в России, это актуально). И хотя сайт посвящён транскрипции с немецкого, вы можете смело запросить у меня работу с русскоязычными документами, если это для вас актуально.
Будет здорово, если ещё
больше исследователей семейной истории узнают о перипетиях судеб и характерах своих предков из архивных источников, которые не всегда легко прочитать. Надеюсь быть вам в этом полезен.
С добрыми пожеланиями,
Артём В. Васильев
Old German Handwriting Transcription
Crafted by a von Pfeilitzer-Franck Descendant
mein Name ist Artjom Wassiljew und ich bin von Beruf Industrie-Journalist. Seit mehr als 15 Jahren beschäftige ich mich jedoch parallel mit deutschsprachigen Archivdokumenten – zunächst im Rahmen meiner eigenen genealogischen Forschung, später auch für andere interessierte Menschen. Meine Forschungsinteressen und mein geografisches Arbeitsgebiet umfassen vor allem die Archive des Baltikums – Lettlands, Estlands und Litauens – sowie der deutschsprachigen Länder (Deutschland, Österreich und die Schweiz). Eine bedeutende Sammlung deutschbaltischer Dokumente befindet sich außerdem in Schweden; auch mit diesen Dokumenten habe ich gearbeitet.
Hier und heute biete ich Ihnen jedoch keine Archiv-Recherchedienstleistungen an, sondern die Transkription – also die Entzifferung handschriftlicher Dokumente in alter deutscher Schrift (Kurrentschrift, Sütterlin). Diese sogenannten „gotischen“ Schriften sind selbst für Muttersprachler oft schwer lesbar, da sich die historische Kalligrafie deutlich von der heute gebräuchlichen unterscheidet. Die Dokumente, die ich für Sie transkribieren kann, stammen aus staatlichen oder behördlichen Archiven – oder aus Ihrem Familienbesitz.
Am Ende jedes Kalenderjahres nehme ich mir einen ganzen Tag Zeit, um die jeweils aktuellen maschinellen und KI-Lösungen gezielt für die Transkription deutscher Kurrentschrift zu testen. Ich probiere alle auf dem Markt verfügbaren Modelle aus – grundsätzlich in den Bezahlversionen, also mit vollem Funktionsumfang. Ich messe die Fehlerquote und die Zeit, die für Upload, Verarbeitung und Strukturierung der Ergebnisse draufgeht, und vor allem den Aufwand an Zeit und Energie für die Gegenkontrolle mit der Originalhandschrift und das Einpflegen der Korrekturen.
Auf demselben Material mit einer nicht besonders komplizierten, recht sauberen Handschrift erzielten die vorhandenen Lösungen – wohlgemerkt nur diejenigen, die tatsächlich Text erkennen und nicht halluzinieren – Fehlerraten zwischen 3 % und 16 % falsch erkannter Wörter, wobei sowohl grammatische Entstellungen als auch völlig falsche Lesarten eingerechnet sind. Eine solche Quote entspricht falschen Einträgen in jeder dritten bis jeder ersten Zeile des handschriftlichen Textes. Das verzerrt das inhaltliche Bild deutlich und macht das Material in dieser Form kaum tauglich, selbst für eine maschinelle Übersetzung: Fehler in Funktionswörtern lassen sich zwar oft noch von Hand oder per KI ausbügeln, doch das Auftauchen von Wörtern oder Buchstabenkombinationen, die im Originaldokument gar nicht vorkommen, führt zu falschen Deutungen des Sachverhalts.
Unterm Strich hat mein Test-Drive gezeigt: Die Zeit, die in die Bearbeitung und Korrektur der Ergebnisse einer automatischen Transkription einer einfachen Handschrift fließt – inklusive Auffinden und Ausmerzen sämtlicher Fehler –, entspricht ungefähr der Zeit, die ich benötige, um denselben Text von Hand zu transkribieren (und ich tippe dabei recht schnell, im Zehnfingersystem und blind).
Eine eigene Modelllösung trainieren, um noch bessere Resultate zu erzielen? Das ist dann sinnvoll, wenn Sie es mit einem sehr großen Korpus von Dokumenten zu tun haben, die alle von derselben Hand geschrieben wurden. In typischen Archivakten herrscht jedoch eine solche Vielfalt an Handschriften, dass sich darin Blätter finden, mit denen ein individuell trainiertes Modell gut zurechtkommt (also mit ein paar Prozent Fehlern), und andere, bei denen mehr als die Hälfte der Wörter falsch erkannt wird. Zumindest ist das meine Erfahrung: Die Zeit, die in das Training eines Modells auf einen konkreten Dokumentenkorpus (im Umfang von einigen Dutzend oder auch ein bis zwei Hundert Blättern) fließt, übersteigt den Aufwand für eine eigenhändige Transkription – und ganz ohne Abgleich mit anschließenden Korrekturen geht es ohnehin nicht.
Bei einer Transkription Zeile für Zeile ist es entscheidend, den Kontext und den gedanklichen roten Faden des gesamten Dokuments im Blick zu behalten – etwas, was maschinelle Modelle derzeit noch nicht leisten. Nimmt man anschließend eine zusätzliche KI-Bearbeitung der maschinellen Transkription vor, beginnt die KI zu halluzinieren: Sie ersetzt Wörter willkürlich durch ähnliche und erfindet Passagen, die im Ausgangstext nie standen. Solche Überraschungen können Sie nicht zuverlässig entdecken, wenn Sie die Kurrentschrift nicht selbst lesen können.
Zu berücksichtigen sind zudem die Besonderheiten bei Personennamen, geografischen Bezeichnungen, veralteten Begriffen und dialektalen Varianten, die in einer alten Handschrift aus einer bestimmten Region auftreten. Auf professionellem Niveau kann all diese Aufgaben bislang nur ein lebendiger Mensch lösen, der das Lesen altdeutscher Schriften (Kurrent, Sütterlin u. a.) wirklich beherrscht.
Und schließlich kommen Sie an einer professionellen Transkription nicht vorbei, wenn Sie planen, jetzt oder in Zukunft auf Grundlage der transkribierten Dokumente zu publizieren.
Daher lautet meine Antwort und Empfehlung:
– und erst recht, wenn Sie bereits Zeit, Nerven und womöglich Geld in maschinelle und KI-Tools investiert haben und zum Schluss kommen, dass Ihre konkreten Dokumente doch fachkundige Handarbeit brauchen,
die Ihre Vorfahren an verschiedene Institutionen stellten und dabei ihre Lebensumstände schilderten
die oft spannende Episoden mit Beteiligung Ihrer Verwandten enthalten und sogar deren Charakterzüge offenbaren können
bei denen Ihre Vorfahren eine offizielle Bestätigung ihres Standes beantragten
wie Kaufverträge oder Inventarlisten, die interessante Einblicke in den Alltag und die Wirtschaft Ihrer Familie bieten können
aus Schul-, Militär- oder Zivildienstzeiten Ihrer Vorfahren
und vieles mehr.
Eine Ausnahme gibt es: Ich übernehme keine Transkription von kurzen, einzelnen Einträgen aus Kirchenbüchern (z.B. Taufen, Konfirmationen, Trauungen, Sterbefälle), Personenstandsurkunden und ähnlichen Dokumenten.
Für solche Fälle finden Sie kostenlose Hilfe von Freiwilligen – suchen Sie einfach nach „German Transcription“ auf Facebook und stellen Sie Ihre Anfrage in den entsprechenden Gruppen.
Wenn Sie jedoch eine umfangreichere Transkription (eine Seite mit dichtem Text, mehrere oder zahlreiche Dokumentenseiten) benötigen, können Sie sich gerne an mich wenden.
An
Sr. Excellence den Liefländischen Herrn
Civil Gouverneur, wirklichen Staats-
rath und Ritter von Repieff.
Nach nunmehro geschloßener Un-
tersuchung hat das Kaiserl. Per-
nausche Ordnungsgericht in Folge
des erhaltenen hohen Auftrages
d. d. 4 Maertz 1811 sub Nro 571 nicht
ermangeln sollen Ewr. Excellence
hieneben pflichtschuldigst das ge-
führte Untersuchungs Potocoll
zu übersenden und dabey fol-
gendes ganz gehorsamst zu un-
terlegen.
1) Durch die fol. act. 16 gemachte
Anzeige des Surryschen Post-
knechts Jacob läßt es sich wohl
praesumiren, daß auch die fol.
act. 7, 8, 9, 10 und 11 gemachte Aus-
sage des Kurkundschen Post-
knechts Andres wahr und es
gegründet sey, daß der Lieutenant
Sie können mir Fotokopien oder Scans Ihrer Materialien per E-Mail zusenden (bitte verkleinern Sie die Dateien nicht, sondern schicken Sie die Bilder in der höchstmöglichen Auflösung oder geben Sie einen direkten Download-Link zu einem Cloud-Ordner/Archiv an). Ich prüfe die Lesbarkeit und schätze die Bearbeitungszeit ein (in der Regel übernehme ich sofort Handschriften aus dem späten 18., 19. und 20. Jahrhundert, bei älteren Dokumenten entscheide ich je nach Einzelfall).
Sie können mir auf Englisch, Deutsch oder Russisch schreiben. Grundsätzlich können Sie auch in jeder anderen Sprache anfragen – ich lese Ihre Nachricht dann mit Hilfe maschineller Übersetzung und antworte Ihnen ebenso, damit es für Sie bequem ist.
Den ungefähren Preis können Sie im Voraus selbst einschätzen: Ich berechne 0,10 Euro pro gelesenem Wort (das ist der niedrigste Satz, den ich unter Kollegen kenne). In seltenen Fällen besonders origineller oder schwer lesbarer Handschriften, die ich dennoch übernehme, stimmen wir vorab einen Aufschlag für die betreffenden Seiten ab. Nicht entzifferbare Passagen oder Wörter, bei denen ich mir nicht sicher bin, werden selbstverständlich nicht berechnet.
Als russischer Muttersprachler kann ich für Sie auch russischsprachige Dokumente transkribieren (was für viele, deren Vorfahren einst in Russland lebten, relevant ist). Auch wenn sich die Website auf deutsche Transkriptionen konzentriert, können Sie mich gerne auch für russische Dokumente anfragen.
Es
wäre grossartig, wenn noch mehr Familienforscher die Schicksale und Charaktere ihrer Vorfahren anhand von Archivquellen entdecken, die nicht immer leicht zu entziffern sind. Ich hoffe, Sie dabei unterstützen zu können.
Mit den besten Wünschen für bereichernde Entdeckungen auf Ihrer Reise in die Vergangenheit,
Artjom W. Wassiljew
Old German Handwriting Transcription
Veidojis fon Feiliceru-Franku dzimtas pēctecis
Mani sauc Artjoms Vasiļjevs, pēc profesijas esmu žurnālists un rakstu par rūpniecību. Taču jau vairāk nekā 15 gadus līdztekus strādāju ar dokumentiem vācu valodā arhīvos — sākumā tas bija vajadzīgs maniem paša ģenealoģiskajiem pētījumiem, bet vēlāk sāku palīdzēt arī citiem aizrautīgiem cilvēkiem. Manas pētnieciskās intereses un darbības ģeogrāfija galvenokārt aptver Baltijas — Latvijas, Igaunijas un Lietuvas — un vāciski runājošo zemju (Vācijas, Austrijas, Šveices) arhīvus. Ievērojams vācbaltiešu dokumentu krājums glabājas arī Zviedrijā, un esmu strādājis arī ar šiem dokumentiem.
Šeit un šobrīd gan piedāvāju nevis arhīvu meklējumu pakalpojumus, bet transkripciju — tas ir, senajā vācu rokrakstā (Kurrentschrift, Sütterlin) rakstītu dokumentu atšifrēšanu. Šie rakstības veidi, ko ikdienā mēdz saukt par gotisko rakstu, grūtības sagādā pat mūsdienu lasītājiem, kam vācu valoda ir dzimtā, jo senā kaligrāfija atšķiras no mūsdienās pieņemtās. Dokumenti, kuru transkripciju varat man uzticēt, var būt no jebkura valsts vai resora arhīva — vai arī no jūsu ģimenes arhīva.
Katra kalendārā gada beigās es atvēlu veselu dienu, lai izmēģinātu aktuālos automatizētos un mākslīgā intelekta (MI) risinājumus tieši vācu Kurrent raksta transkripcijai. Izmēģinu visus tirgū pieejamos modeļus (noteikti maksas versijās, tātad ar iespējami plašāko funkcionalitāti). Nosaku kļūdu īpatsvaru, kā arī laiku, kas vajadzīgs augšupielādei, apstrādei un rezultātu sistematizēšanai, un pats galvenais — laiku un pūles, ko prasa salīdzināšana ar oriģinālo rokrakstu un labojumu veikšana.
Izmantojot vienu un to pašu materiālu ar nesarežģītu un visai glītu rokrakstu, pieejamie risinājumi (taču tikai tie, kuri patiešām atpazīst tekstu, nevis halucinē) kļūdaini atpazina no 3% līdz 16% vārdu — te ietilpst gan gramatiskas novirzes, gan pilnīgi aplami lasījumi. Šāds īpatsvars nozīmē kļūdainus lasījumus katrā trešajā vai pat katrā rokraksta rindā, un tas būtiski izkropļo priekšstatu par saturu un padara materiālu šādā veidā maz piemērotu pat mašīntulkošanai: ja kļūdas palīgvārdos vēl var izlabot manuāli vai ar MI palīdzību, tad tādu vārdu vai burtu savienojumu parādīšanās, kuru oriģinālajā dokumentā nav bijis, noved pie aplamiem lietas apstākļu skaidrojumiem.
Galu galā mans izmēģinājums parādīja: laiks, kas nepieciešams nesarežģīta rokraksta automātiskās transkripcijas rezultātu apstrādei un labošanai, atrodot un izlabojot visas kļūdas, ir aptuveni tikpat ilgs kā laiks, ko es patērēju, manuāli atšifrējot šo pašu tekstu (turklāt es diezgan ātri rakstu uz tastatūras, uz to neskatoties).
Apmācīt savu modeli, lai iegūtu vēl labākus rezultātus? Tam ir jēga, ja jūsu rīcībā ir liels dokumentu kopums, ko rakstījis viens un tas pats cilvēks. Taču arhīva lietās parasti ir tāds rokrakstu sajaukums, ka tajās būs gan lapas, ar kurām individuāli apmācīts modelis tiks galā labi (proti, ar pāris procentiem kļūdu), gan tādas, kurās kļūdaini atpazīto vārdu īpatsvars pārsniegs pusi. Vismaz tāda ir mana pieredze — laiks, kas jāpatērē, lai apmācītu modeli konkrētam dokumentu kopumam (dažiem desmitiem vai pat pāris simtiem lapu), pārsniedz laiku, kurā es pats varu tos transkribēt manuāli, turklāt no salīdzināšanas ar oriģinālu un labojumu veikšanas tik un tā nevar izvairīties.
Transkribējot rindu pa rindai, ir svarīgi paturēt redzeslokā visa dokumenta kontekstu un jēgas pavedienu — to automatizētie modeļi pagaidām nenodrošina (savukārt, ja automātiski iegūtos transkripcijas rezultātus papildus apstrādā ar MI, tas halucinē — patvaļīgi aizstāj tekstā vārdus ar līdzīgiem un izdomā to, kā oriģinālajā dokumentā nav bijis; šādus pārsteigumus jūs nekādi nevarēsiet pamanīt, ja pats Kurrent rakstu nelasāt).
Ir svarīgi ņemt vērā arī personvārdu un vietvārdu rakstības īpatnības, mūsdienās vairs nelietotus terminus un dialektālās atšķirības, kas sastopamas noteiktā teritorijā tapušā senā rokrakstā. Profesionālā līmenī ar visiem šiem uzdevumiem pagaidām spēj tikt galā tikai dzīvs cilvēks, kurš prot lasīt senos vācu rokraksta veidus.
Visbeidzot, bez profesionālas transkripcijas nekādi neiztikt, ja jūs tagad vai nākotnē plānojat veidot publikāciju, balstoties uz transkribētajiem dokumentiem.
Tāpēc mana atbilde un ieteikumi ir šādi —
— visbeidzot, ja jau esat iztērējis laiku, nervus un, iespējams, arī naudu, izmēģinot automatizētos un MI rīkus, un nonācis pie secinājuma, ka tieši jūsu uzdevumiem ir vajadzīgs eksperta darbs, kas veikts manuāli, —
kurus jūsu senči iesniedza dažādās iestādēs, aprakstīdami savas dzīves situācijas
bieži vēsta par spilgtiem notikumiem, kuros bijuši iesaistīti radinieki, un var pat palīdzēt atklāt viņu raksturus
kur jūsu senči vērsās, lai saņemtu oficiālu apliecinājumu savai piederībai noteiktai kārtai
piemēram, pirkuma līgumi vai inventāri, var ietvert interesantas ziņas par sadzīvi un saimniecību
no mācību iestāžu, kā arī senču militārā vai civilā dienesta vietu fondiem
un vēl daudz, daudz kas cits.
Ir viens izņēmums — dokumenti, kurus neuzņemos atšifrēt: tie ir īsi, atsevišķi ieraksti baznīcu metriku grāmatās (par kristībām, iesvētīšanu, laulāšanu, miršanu), civilstāvokļa aktu reģistrācijas apliecības un tamlīdzīgi dokumenti.
Varat atrast brīvprātīgos, kuri palīdzēs šādus ierakstus izlasīt bez maksas: pietiek, piemēram, Facebook meklētājā ierakstīt German Transcription un ievietot savu lūgumu atbilstošajās grupās, kuras tur atradīsiet.
Ja tomēr vēlaties transkribēt apjomīgāku materiālu (blīvi aprakstītu lappusi, dažas vai daudzas dokumentu lapas), lūdzu, droši vērsieties pie manis.
An
Sr. Excellence den Liefländischen Herrn
Civil Gouverneur, wirklichen Staats-
rath und Ritter von Repieff.
Nach nunmehro geschloßener Un-
tersuchung hat das Kaiserl. Per-
nausche Ordnungsgericht in Folge
des erhaltenen hohen Auftrages
d. d. 4 Maertz 1811 sub Nro 571 nicht
ermangeln sollen Ewr. Excellence
hieneben pflichtschuldigst das ge-
führte Untersuchungs Potocoll
zu übersenden und dabey fol-
gendes ganz gehorsamst zu un-
terlegen.
1) Durch die fol. act. 16 gemachte
Anzeige des Surryschen Post-
knechts Jacob läßt es sich wohl
praesumiren, daß auch die fol.
act. 7, 8, 9, 10 und 11 gemachte Aus-
sage des Kurkundschen Post-
knechts Andres wahr und es
gegründet sey, daß der Lieutenant
Varat nosūtīt man materiālu fotokopijas vai skenējumus pa e-pastu (lūdzu, nesamaziniet failus, bet atsūtiet attēlus visaugstākajā pieejamajā oriģinālajā izšķirtspējā vai iedodiet tiešu saiti mapes vai failu arhīva lejupielādei no mākoņkrātuves), un es novērtēšu to salasāmību un darba izpildes laiku (parasti uzreiz uzņemos strādāt ar 18. gadsimta beigu, 19. un 20. gadsimta rokrakstiem; ar agrāku laiku dokumentiem — atkarībā no situācijas).
Varat rakstīt man angļu, vācu vai krievu valodā. Principā varat nosūtīt pieprasījumu arī jebkurā citā valodā — tad es to izlasīšu, izmantojot mašīntulkojumu, un jūsu ērtībai tāpat arī atbildēšu.
Aptuvenās izmaksas varat iepriekš aprēķināt paši: par katru izlasīto vārdu es prasu 0,10 eiro (tā ir zemākā likme, kādu esmu sastapis kolēģu vidū). Retajos gadījumos, kad rokraksts ir ārkārtīgi savdabīgs vai paviršs, bet es tomēr esmu gatavs darbu uzņemties, mēs iepriekš vienosimies par paaugstinātu samaksas koeficientu atsevišķām lapām jūsu dokumentu kopumā. Ja tekstā būs fragmenti, kurus nebūs izdevies transkribēt, vai vārdi, par kuriem nebūšu pārliecināts, par tiem samaksa netiks prasīta.
Tā kā mana dzimtā valoda ir krievu valoda, varu jums atšifrēt arī dokumentus krievu valodā (zinu, ka daudziem, kuru senči savulaik dzīvojuši Krievijā, tas ir aktuāli). Un, lai gan šī vietne ir veltīta transkripcijai no vācu valodas, droši varat man jautāt arī par darbu ar dokumentiem krievu valodā, ja jums tas ir vajadzīgs.
Būtu lieliski, ja vēl vairāk dzimtas vēstures pētnieku no arhīvu avotiem, kurus ne vienmēr ir viegli izlasīt, uzzinātu par savu senču likteņu līkločiem un raksturiem. Ceru, ka varēšu jums šajā darbā noderēt.
Vēlot jums vērtīgus atklājumus pagātnes izzināšanā,
Artjoms V. Vasiļjevs
Old German Handwriting Transcription
Crafted by a von Pfeilitzer-Franck Descendant
My name is Artem Vasilev, and by profession, I am an industrial journalist. For more than 15 years, however, I have also been working with German-language archival documents — initially for my own genealogical research, and later on behalf of other passionate researchers. My research interests and geographical focus primarily cover the archives of the Baltic States — Latvia, Estonia and Lithuania — and the German-speaking countries (Germany, Austria and Switzerland). A substantial collection of Baltic German documents is also held in Sweden, and I have worked with those documents as well.
Here and now, I am not offering archival search services, but rather transcription — that is, the deciphering of handwritten documents in old German script (Kurrentschrift, Sütterlin). These scripts, commonly referred to as “Gothic,” are a challenge even for native German speakers, as the old calligraphy differs significantly from what is used today. The documents you can have transcribed with my assistance may come from any state or institutional archive — or from your own family collection.
At the end of every calendar year, I set aside an entire day to test the current generation of machine and AI solutions specifically for transcribing German Kurrent script. I try all models available on the market (always in their paid versions, with full functionality enabled). I measure the error rate, the time it takes to upload, process and organise the results, and, most importantly, the time and effort required to compare everything with the original manuscript and correct the errors.
On the same sample text, written in a fairly neat and not particularly difficult hand, the available solutions (and here I only count those that actually recognise text rather than hallucinate it) produced between 3% and 16% incorrectly recognised words, including both grammatical distortions and completely wrong readings. In practice, this means false entries in every third to every single line of the manuscript. This significantly distorts the overall meaning and makes the material, in that raw form, barely suitable even for machine translation: while errors in function words can often be corrected manually or with AI, the appearance of words or clusters of letters that are not in the original document at all inevitably leads to false interpretations of the facts of the case.
In the end, my “test drive” showed the following: the time needed to process and correct the output of an automatic transcription of a simple hand – including detecting and fixing all errors – is roughly the same as the time I spend transcribing the very same text manually (and I type quite fast, touch-typing and without looking at the keyboard).
Training your own model to get even better results? This can make sense if you are dealing with a very large set of documents all written by the same person. In archival files, however, you usually encounter such a patchwork of different hands that within one file you will have pages on which a custom-trained model performs very well (with only a few percent of errors) and others on which more than half of the words are misrecognised. At least, that has been my experience: the time invested in training a model for a specific corpus (say, a few dozen or even a couple of hundred pages) exceeds the time it would take to transcribe them manually – and you still cannot avoid checking and correcting the results afterwards.
When you transcribe line by line, it is crucial to keep the overall context and argument of the document in view. Current machine models are not yet capable of this. And if you add an additional AI “post-processing” step on top of the machine transcription, the AI starts hallucinating: it arbitrarily replaces words with similar ones and invents things that were never in the original document. If you do not read Kurrent yourself, there is simply no way to reliably detect such surprises.
You also have to take into account the specific ways in which personal names, place names, obsolete terms and dialect forms appear in an old manuscript created in a particular region. At a genuinely professional level, all these tasks can, for the time being, only be handled by a real human being who has mastered the art of reading old German scripts.
And finally, professional transcription is indispensable if you plan, now or later, to publish anything based on the transcribed documents.
So here is my answer and recommendation —
— and especially if you have already spent time, nerves and perhaps money experimenting with machine and AI tools, only to conclude that your particular documents require expert manual work —
that your ancestors submitted to various institutions, describing their life situations
which often contain vivid stories involving your relatives and can even help reveal their characters
where your ancestors applied for official confirmation of their social status
such as deeds of sale or inventories, which may contain fascinating details about everyday and economic life
from educational institutions, military, or civil service records of your ancestors
and much, much more.
There is one exception — documents I do not transcribe: these are short, isolated entries from church books (baptisms, confirmations, marriages, deaths), civil-status certificates and similar documents.
You can find volunteers to help you read such entries for free: simply search for “German Transcription” on Facebook, for example, and post your request in the relevant groups you find there.
However, if you wish to have a more substantial amount transcribed (a page of dense text, several or many sheets of documents), please feel free to contact me.
An
Sr. Excellence den Liefländischen Herrn
Civil Gouverneur, wirklichen Staats-
rath und Ritter von Repieff.
Nach nunmehro geschloßener Un-
tersuchung hat das Kaiserl. Per-
nausche Ordnungsgericht in Folge
des erhaltenen hohen Auftrages
d. d. 4 Maertz 1811 sub Nro 571 nicht
ermangeln sollen Ewr. Excellence
hieneben pflichtschuldigst das ge-
führte Untersuchungs Potocoll
zu übersenden und dabey fol-
gendes ganz gehorsamst zu un-
terlegen.
1) Durch die fol. act. 16 gemachte
Anzeige des Surryschen Post-
knechts Jacob läßt es sich wohl
praesumiren, daß auch die fol.
act. 7, 8, 9, 10 und 11 gemachte Aus-
sage des Kurkundschen Post-
knechts Andres wahr und es
gegründet sey, daß der Lieutenant
You can send me photocopies or scans of your materials by email (please do not reduce the file size — send images in the highest available original resolution, or provide a direct link to download a folder/archive from cloud storage). I will assess their legibility and estimate the turnaround time (I usually take on scripts from the late 18th, 19th, and 20th centuries right away; for earlier periods, it depends on the specific case).
You are welcome to write to me in English, German, or Russian. In principle, you can send your request in any other language as well — I will read it using machine translation and reply in the same way for your convenience.
You can estimate the approximate cost yourself in advance: I charge €0.10 per word transcribed (this is the lowest rate I have seen among my colleagues). In rare cases of particularly original or careless handwriting that I am nevertheless willing to take on, we will agree in advance on a higher rate for specific pages in your set of documents. Any portions of text that cannot be transcribed, or words I am not confident about, will be excluded from the fee.
As a native Russian speaker, I can also transcribe documents in Russian for you (I know this is relevant for many whose ancestors once lived in Russia). And although this website is dedicated to German transcription, you are welcome to request work with Russian-language documents if that is relevant for you.
It
would be wonderful if even more family history researchers could learn about the fates and characters of their ancestors from archival sources that are not always easy to read. I hope I can be of help to you in this endeavor.
Wishing you rewarding discoveries on your journey through the past,
Artem Vasilev